
Qué es el DGX Spark
NVIDIA presentó el DGX Spark como la versión compacta de su línea DGX, la misma que alimenta los clústeres de entrenamiento de los grandes labs. La diferencia es el formato: en lugar de un rack de 8U en un data center, el Spark cabe sobre un escritorio y se conecta con un solo cable de corriente.
El chip en el núcleo es el GB10 Grace Blackwell Superchip, que integra en un solo SoC una GPU Blackwell de 128 GB de memoria unificada LPDDR5X y una CPU Grace de 20 núcleos ARM. La memoria unificada es el punto técnico más relevante: la GPU y la CPU comparten el mismo banco de memoria con un ancho de banda de 273 GB/s, eliminando el cuello de botella de transferencia PCI que limita los setups convencionales.
El resultado práctico es que puedes correr un modelo de 200 mil millones de parámetros en FP4 completamente en memoria, sin cuantización agresiva ni offloading a disco.
Por qué importa para developers
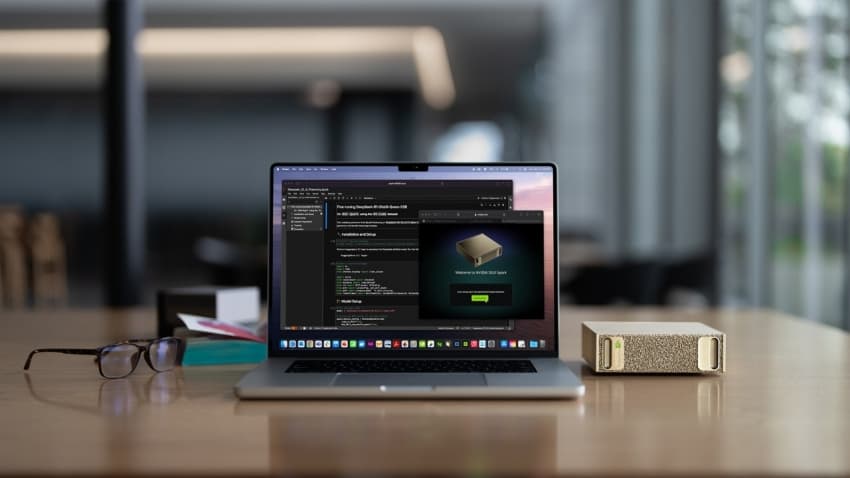
El ecosistema de NVIDIA AI Enterprise corre completo sobre el Spark. Eso incluye NIM (NVIDIA Inference Microservices), el stack de RAG con cuRVS, las librerías de aceleración RAPIDS para Python, y soporte nativo para los frameworks principales: PyTorch, JAX, TensorRT-LLM.
Para quien trabaja con modelos open-weight como Llama 3.1 405B, Mistral Large, DeepSeek R1, o Qwen 2.5 72B, el Spark ofrece suficiente memoria para correrlos sin cuantización a 8-bit. Los modelos de 7B a 70B corren con margen holgado, lo que permite hacer batch inference o mantener múltiples modelos cargados simultáneamente.
Un PFLOP de potencia FP4 en un dispositivo de consumo que cabe debajo de un monitor es una declaración técnica más que una especificación de marketing.
El stack de software
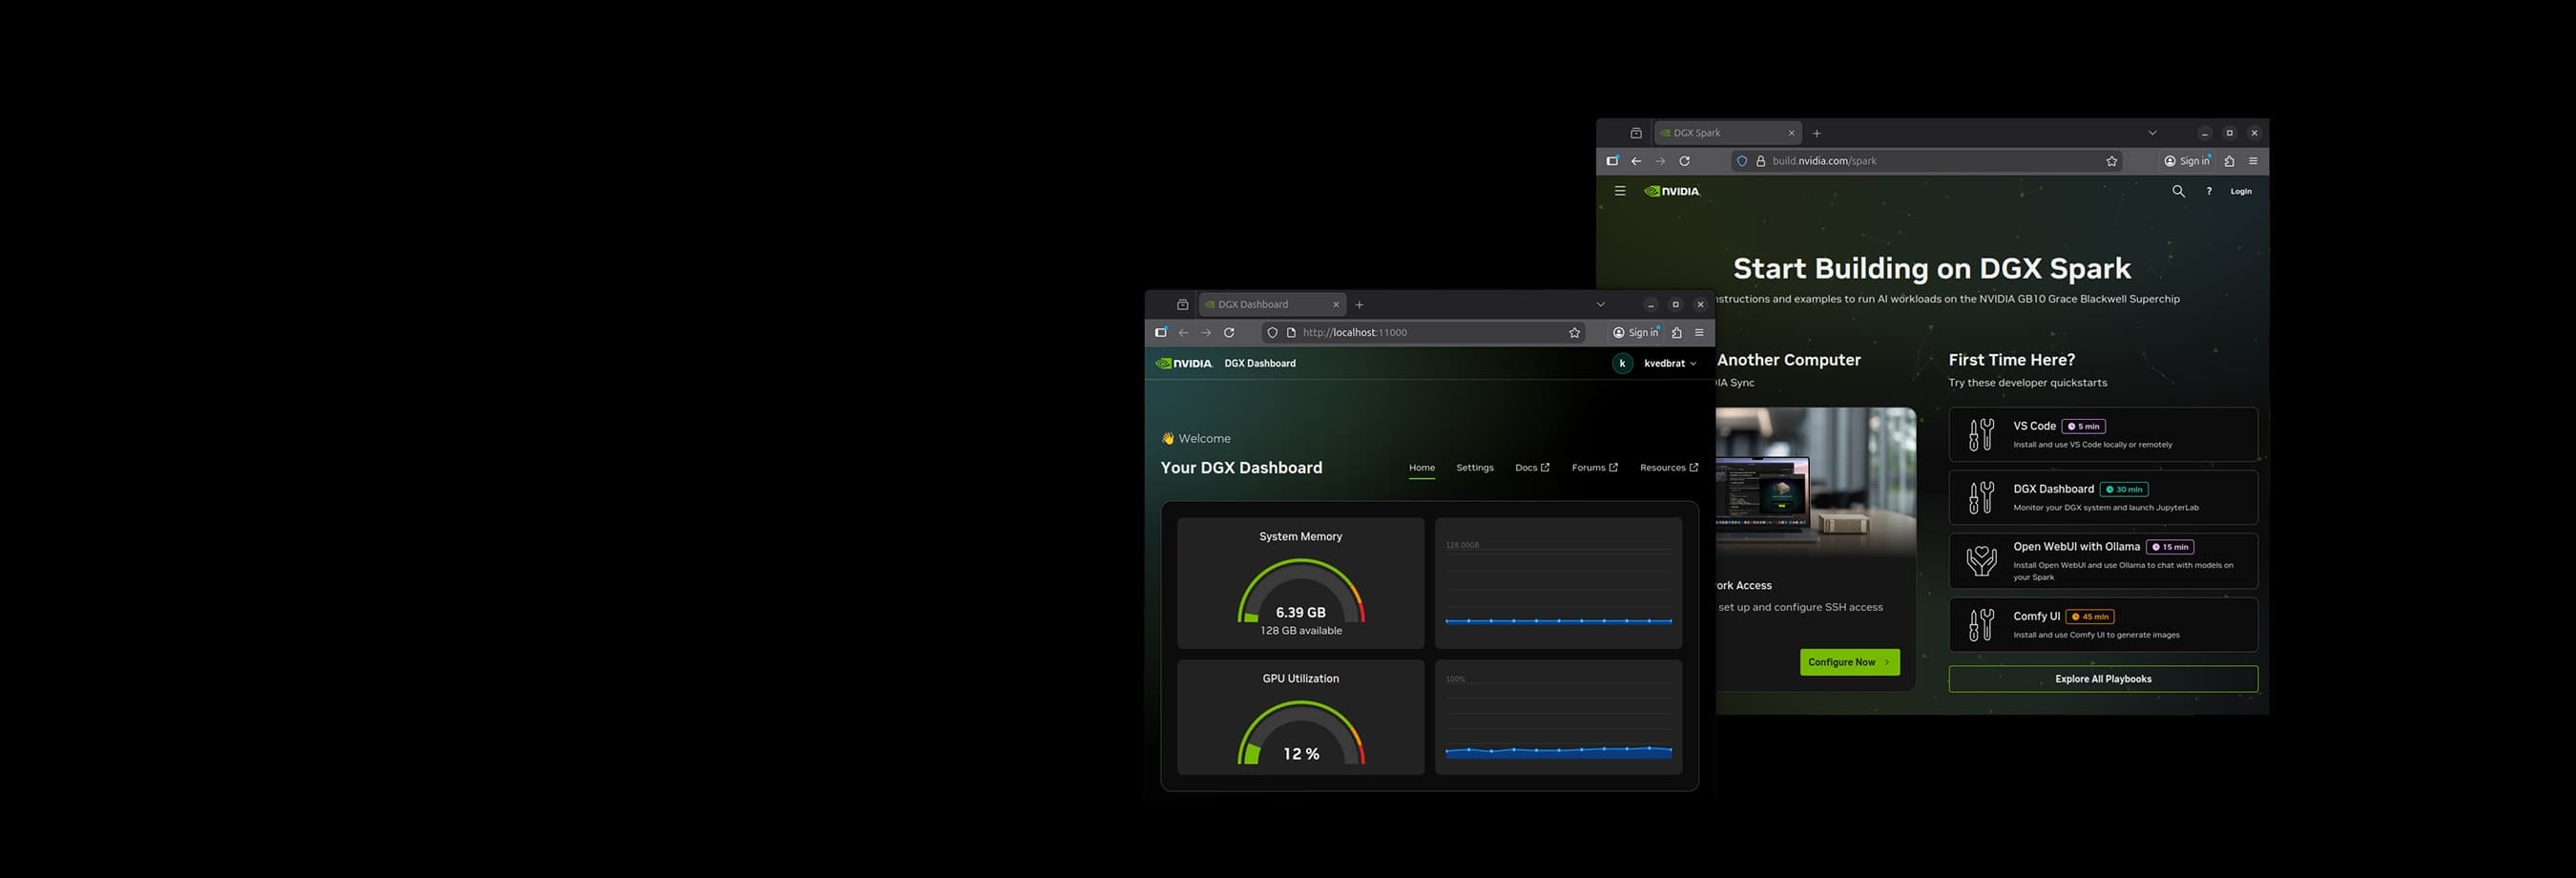
La propuesta de valor no es solo el hardware. NVIDIA empaqueta el Spark con acceso completo a su catálogo de NIM microservices, que incluye modelos preempaquetados y optimizados para inferencia en arquitecturas Blackwell. El setup inicial es un asistente gráfico que configura el sistema en menos de 10 minutos.
Lo que viene preinstalado
- Ubuntu 22.04 LTS con drivers CUDA 12.x
- NVIDIA Container Runtime para Docker
- NVIDIA AI Workbench, el entorno de desarrollo integrado
- Acceso directo al catálogo NGC (NVIDIA GPU Cloud)
- Soporte para Ollama y LM Studio como alternativas ligeras
Interoperabilidad
El Spark incluye dos puertos NVLink-C2C que permiten conectarlo con otro Spark para escalar a 256 GB de memoria unificada compartida. También tiene conectividad directa con el DGX Station B200 para pipelines híbridos local + servidor sin cambiar el código de la aplicación, dado que ambos comparten el mismo stack CUDA-X.
Hardware y conectividad
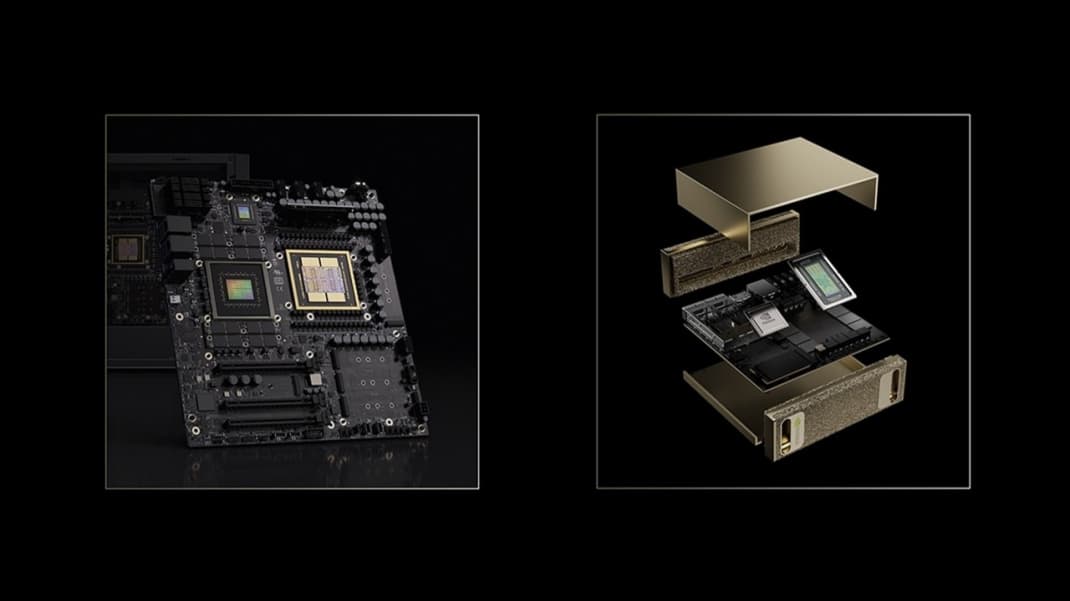
El chasis es compacto y completamente pasivo en los primeros 100W de carga. Para cargas sostenidas activa un sistema de refrigeración interno de bajo ruido. Los puertos incluyen USB-C Thunderbolt 4, HDMI 2.1, Ethernet 1GbE, y los dos puertos propietarios NVLink para expansión entre nodos.
Comparativa con alternativas
| Dispositivo | Memoria GPU | Potencia IA | Precio aprox. | Stack IA |
|---|---|---|---|---|
| NVIDIA DGX Spark | 128 GB unificada | 1 PFLOP FP4 | ~$3,000 USD | CUDA-X completo |
| Mac Studio M4 Ultra | 192 GB unificada | ~400 TOPS | ~$4,000 USD | MLX / CoreML |
| PC con RTX 5080 | 16 GB GDDR7 | ~836 TOPS | ~$2,000 USD | CUDA parcial |
| PC con RTX 5090 | 32 GB GDDR7 | ~3,352 TOPS | ~$3,500 USD | CUDA completo |
| AWS p4d.24xlarge / hr | 320 GB HBM2e | 2.5 PFLOPS | ~$32 USD/hr | CUDA completo |
La comparativa con cloud es donde el argumento económico del Spark se vuelve más claro. A $32/hr en AWS, el breakeven con el costo del Spark es alrededor de 100 horas de uso de GPU. Para cualquier proyecto de mediana intensidad, eso se alcanza en semanas.
Conclusión
El DGX Spark es un producto de nicho con un nicho muy claro: researchers, ML engineers, y equipos pequeños que necesitan capacidad de inferencia local seria sin gestionar infraestructura cloud. Para ese perfil, la propuesta es difícil de ignorar.
Para un developer que ya tiene una workstation Windows con RTX 5080 o 5090 y usa Ollama para inferencia local, el Spark funciona mejor como complemento que como reemplazo: agrega 128 GB de memoria unificada para modelos grandes mientras la workstation sigue siendo la máquina principal de desarrollo.
Lo que NVIDIA logró técnicamente con el GB10 es real. Un PFLOP de potencia FP4 a menos de 170W en un factor de forma de escritorio no tiene precedente. Si el precio baja o si tu caso de uso requiere correr modelos de 100B+ de forma recurrente, el argumento se vuelve mucho más fuerte.
Pregúntale a este artículo
Eathan · IA de Farid, anclada al texto
Respuestas basadas solo en este artículo.
¿Esto le sirve a tu negocio?
Recibe un diagnóstico de IA gratis, hecho para tu caso en 60 segundos: qué automatizar, qué stack y el primer paso.